venerdì 3 marzo 2017

Pillole di IT Security


  • Pillola n.1: oggi, come si legge nel comunicato stampa, il Consiglio dei Ministri ha conferito (fra l'altro) al Governo la Delega legislativa per il recepimento della "DIRETTIVA (UE) 2016/1148 DEL PARLAMENTO EUROPEO E DEL CONSIGLIO del 6 luglio 2016 recante misure per un livello comune elevato di sicurezza delle reti e dei sistemi informativi nell'Unione". Se avete voglia di digerire un po' di legalese, ecco il testo della Direttiva. In particolare, vorrei sottolineare il seguente comma:
 (29)
Per conseguire e mantenere un livello elevato di sicurezza della rete e dei sistemi informativi è opportuno che ogni Stato membro disponga di una strategia nazionale in materia di sicurezza della rete e dei sistemi informativi che definisca gli obiettivi strategici e gli interventi strategici concreti da attuare.


  • Pillola n.2: corre voce che siano stati cancellati dal Playstore di Android (il sito che contiene le famose "app" scaricabili) una decina di App che andavano a infettare sistemi Windows. Sì, avete capito bene: questo malware utilizzava Android come "cavallo di Troia" per andare a infettare con altro malware ad esso affiliato i sistemi Windows che casualmente entrassero in contatto col telefonino o tablet infetto. Una tattica piuttosto contorta per andare a colpire sistemi già abbondantemente esposti a malware di vario tipo. Purtroppo non ho trovato riscontri* a questa notizia, anche se la fonte pare abbastanza autorevole 
(rif: https://www.facebook.com/unavitadasocial/photos/a.204543133076485.1073741828.202526769944788/606385862892208/).

*Aggiornamento: la notizia parte da questo articolo di Palo Alto Networks, una società che si occupa di Sicurezza in rete. Come spiegato in quel post,

What is more notable is that, one of the infected pages also attempts to download and install a malicious Microsoft Windows executable file at the time of page loading, but as the device is not running Windows, it will not execute.
 Come si legge qui, si tratta di

Non-Android threat: An application that contains non-Android threats. These apps are unable to cause harm to the user or Android device, but contain components that are potentially harmful to other platforms.
Quello che rimane tecnicamente un mistero è come una IFrame aperta su un device Android e contenente malware eseguibile su Windows possa andare ad infettare un device Windows. Ai posteri l'ardua sentenza!

giovedì 2 marzo 2017

Aggiornamento: il fattore umano

Questo post riporta alcuni aggiornamenti (follow-up) rispetto al precedente post, che prendeva spunto dall'episodio di malfunzionamento dei servizi Amazon S3.

In un articolo abbastanza esauriente, Amazon rivela le cause e i meccanismi che hanno portato al malfunzionamento.

In estrema sintesi, un comando attivato per risolvere ben più lievi problemi (fatturazione), usato in modo improprio ha disattivato alcuni elementi critici per il funzionamento di tutto il sistema Amazon S3 della zona Nord America (che in sostanza è un servizio di cloud storage, spazio disco distribuito).

Le lezioni principali che ci sentiamo di trarre da questa vicenda sono le seguenti:

  • mai sottovalutare i single point of failure (SPOF) di un sistema complesso: in questo caso, ben due funzioni critiche (index subsystem e allocation s.) erano state affidate ad altrettanti blocchi monolitici all'interno del sistema stesso
  • mai fidarsi del fatto che la quantità di dati trattati non introduca ulteriori problemi in maniera più che lineare: far ripartire i due citati sottosistemi, che non erano finora mai stati spenti, con tutta la mole di dati accumulati in questo tempo non è stato facile, e soprattutto ha impiegato più tempo del previsto
  • mai sottovalutare le interrelazioni fra le singole parti di un sistema complesso: il fatto che l'allocation subsystem per ripartire avesse bisogno dell'index subsystem funzionante ha peggiorato ulteriormente la situazione
Naturalmente, per ottenere una soluzione strutturale a questo genere di problemi Amazon ha dovuto rivedere la pianificazione di quelle attività di ottimizzazione dell'architettura (e parziale re-ingegnerizzazione) che erano state già previste ma non erano finora considerate urgenti.

Le correzioni immediate agli strumenti in uso erano naturalmente "comprese nel prezzo" pagato per questo incident, come facevamo già rilevare nel precedente articolo.

Un'ultima nota a proposito delle prospettive illusorie di un certo marketing d'assalto: ho sentito teorizzare che questo incident capitato ad Amazon avrebbe aiutato la concorrenza a piazzare meglio la sua soluzione di cloud storage. Secondo me è una boiata pazzesca* tenendo conto che le tecnologie, le architetture, le organizzazioni sottostanti ai sistemi cloud dei diversi fornitori sono sostanzialmente equivalenti: se fosse così facile essere al riparo da quegli imprevisti imprevedibili che sono gli errori umani, sarebbe un bel vantaggio competitivo da far valere prima che la concorrenza cada in un incident.


(*) cit. Fantozzi

martedì 28 febbraio 2017

Disponibilità

Uno dei tre pilastri dell'IT Security si chiama Disponibilità (Availability). A che serve sapere che i miei dati sono "al sicuro", che nessuno (non autorizzato) può vederli o modificarli, se poi al momento in cui mi servono non riesco ad accedervi?

Ne parliamo qui perché in questo momento (18 febbraio 2017, ore 21:54 italiane) uno dei servizi "cloud" maggiormente utilizzato, Amazon AWS S3 (Virginia, USA), sta avendo grossi problemi di disponibilità. Per avere un'idea di che cosa stiamo parlando, realtà come Imgur, Medium, Runkeeper, Trello, e Yahoo webmail dipendono dal buon funzionamento di questo "cloud".

Ricordo benissimo quando il marketing delle architetture "cloud" sbandierava la principale caratteristica superiore del "cloud" rispetto ad altre soluzioni: la disponibilità. E forse, passata la bufera, lo farà ancora. Dicevano che per chi usa i servizi in "cloud" una eventuale riallocazione delle risorse dovuta a qualche malfunzionamento di uno dei siti sarebbe stata del tutto trasparente, e il "cloud" avrebbe garantito una continuità di servizio mai vista senza di esso. Finché, come dico spesso, "la realtà ha sempre ragione", anche sul marketing (o soprattutto su di esso).

Non vorrei essere in questo momento nei panni dei "tecnici" incaricati di capire che cosa non sta funzionando e soprattutto di porvi rimedio il più presto possibile (due obiettivi che quasi mai vanno a braccetto, lo dico per esperienza personale). 

Che cosa accadrà? Ma certamente "in breve tempo" tutto tornerà "normale", o quasi. Se posso azzardare una previsione, ciò che non verrà in breve tempo sarà la spiegazione pubblica di che cosa è accaduto, di come si intende porvi rimedio stabilmente, e soprattutto di come si pensa di evitare che il fatto si ripeta. Si parlerà (sto sempre immaginando) di qualche imprevisto imprevedibile, e si esalteranno (giustamente) le capacità tecniche e organizzative di chi ha saputo porvi rimedio in breve tempo.

Alla fine resterà l'episodio di un disservizio su cui il privato non può accampare molte pretese, mentre per le Aziende tutto dipenderà dalle clausole contrattuali (SLA e relative penali) a suo tempo stabilite per i servizi in "cloud".

Per un'Azienda che subisca un danno (materiale o d'immagine) conta riuscire almeno a recuperare un po' di capitale, da reinvestire per cercare soluzioni più robuste e anche per riguadagnare quella parte di fiducia dei clienti che potrebbe essere andata persa.

E poi qualcuno ancora pensa che l'IT Security sia un costo e non un investimento.


Per quel che ne sanno a The Register:
https://www.theregister.co.uk/2017/02/28/aws_is_awol_as_s3_goes_haywire/

domenica 26 febbraio 2017

Ancora router

Abbiamo già parlato dei rischi legati ai Router che consentono le connessioni internet "da casa" (o dalle postazioni small business). Vedere per esempio questo post.

Partiamo dalla cronaca


Per approfondire l'argomento, ricordiamo innanzi tutto che genere di rischio comportano i router delle connessioni casalinghe forniti dai Provider di connettività.  

Un caso recente (novembre 2016) è l'attacco che ha colpito la rete in Germania, sia per le connessioni dati, che per quelle telefoniche (ricordiamo che la maggior parte delle "linee" telefoniche in Germania sono su tecnologia digitale, via internet). 

Dopo mesi di indagini, si è arrivati forse a individuare uno dei responsabili di quell'attacco, il che tuttavia non tutela dal ripetersi di simili situazioni.

Valutare il rischio


Per poter valutare il rischio reale, occorre analizzare quali sono le condizioni di sicurezza con cui sono distribuiti e amministrati questi router. Vediamo innanzi tutto la teoria.

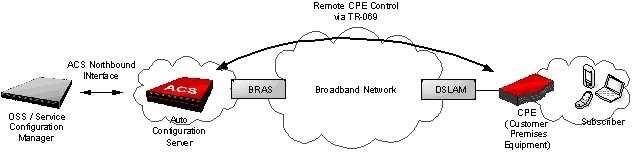
Genericamente, i router dei Provider sono installati e gestiti secondo questo schema:

[1]

Esiste cioè un'apposita infrastruttura del Provider, composta (con riferimento alla figura, da sinistra verso destra) di:
  1. interfaccia centralizzata per la definizione delle configurazioni
  2. server centralizzato per la distribuzione delle configurazioni e degli aggiornamenti
  3. collegamento in rete geografica verso i router installati presso i clienti
  4. molteplicità di router installati, e infine
  5. rete locale del cliente
In questo modo i Provider tengono sotto controllo e gestiscono i router installati presso i clienti, aggiornando se necessario le configurazioni.

L'anello più debole di questa catena è costituito dal collegamento in rete (c) fra i server del Provider e la miriade di router presso i clienti. Se tale connessione non è opportunamente protetta, può essere preda di malintenzionati (cracker), come appunto è accaduto in Germania nell'incidente citato sopra.

Il protocollo di comunicazione fra server e router è definito da alcuni standard, che purtroppo sembrano alquanto vulnerabili ad attacchi da parte di soggetti non autorizzati. 

Un fattore molto importante per la sicurezza di questa architettura è il tipo di connessione geografica (c) fra server e router: 
  • se tale rete ricade interamente sotto il controllo del Provider, allora il rischio di intrusione sui router è decisamente moderato e dipende dal livello di sicurezza di questa rete, che di fatto risulta interna alle infrastrutture del Provider stesso. 
  • se invece tale rete sfrutta o attraversa anche parzialmente la rete pubblica (internet) senza ulteriori protezioni (es: VPN), allora il rischio di intrusione diventa concreto e consistente.


Conclusioni


Che cosa può fare il cliente per scongiurare intrusioni come quelle descritte?

Praticamente niente, salvo chiedere informazioni al suo Provider circa il tipo di infrastruttura usata per la manutenzione del router.

Che cosa dovrebbero fare i Provider?

Assicurarsi che l'accesso ai propri router sia consentito soltanto alle proprie procedure di gestione (server ed eventualmente personale autorizzato), che non vi siano backdoor a bordo dei router (password di fabbrica o universalmente note) e infine che la connessione fra le loro strutture centrali e i router siano opportunamente schermate contro i tentativi di intrusione o spionaggio.

Eventualmente, modificare le modalità di accesso ai router per raggiungere questi obiettivi minimi di sicurezza.


Altri Riferimenti


Note:

[1] (immagine di: de:user:Sternagel - de:Datei:Remote CPE Controle via TR-069.jpg, CC BY-SA 3.0, https://commons.wikimedia.org/w/index.php?curid=9845264)


sabato 25 febbraio 2017

Il rischio corre sul Cloud

"Quello che non c'è, non si guasta": questo proverbiale adagio dei meccanici della Ferrari è sempre valido, anche quando si tratta di Sicurezza IT.

Alcuni servizi in rete sono diventati ormai pane quotidiano per chi con la rete internet ci lavora, e magari le affida business milionari. Questi servizi sono in genere molto utili, e consentono di avere buone funzionalità senza investire in infrastrutture private, che possono essere anche molto costose.

È il caso di quei servizi che offrono "acceleratori" di accesso ai siti web (tecnicamente si parla di "reverse proxy"), con capacità di allocazione dinamica, a seconda del traffico. Uno dei più famosi e maggiormente utilizzati è CloudFlare.

Il Problema


Perché ne parliamo? Accade che c'è stato un problema con questo servizio, più esattamente un "incident" di IT Security: a causa di un errore software (un bug!), questo servizio, in determinate circostanze, forniva agli utenti di un sito informazioni riguardanti un altro sito, magari appartenente a un cliente (azienda) completamente diverso, e ignaro del fatto. Si fa presto a immaginare che, una volta scoperta la falla, i soliti malintenzionati (crackers) potessero studiare come volgere la situazione a loro favore, e a danno di alcuni utenti del servizio (aziende e loro utenti).

Per chi volesse approfondire (sapendo leggere un po' di inglese) il dettaglio è in questo Incident Report pubblicato dalla stessa società Cloudflare.

Come riportato nel Report, i tecnici sono corsi prontamente ai ripari e sono riusciti a "mitigare" gli effetti negativi in appena 47 minuti, chiudendo completamente la falla complessivamente in 7 ore. Per chi lavora nello sviluppo e manutenzione IT questi sono tempi straordinariamente brevi (per avere una correzione di un bug software normalmente passano settimane o mesi), mentre nel caso di un incident di IT Security sono tempi non eccezionali ma accettabili, soprattutto tenendo conto che la falla non era nota (ai famosi crackers) e quindi era praticamente innocua.

Conseguenze per gli utenti


Per la maggior parte degli utenti di servizi online delle aziende indirettamente colpite (cioè quelle che fanno uso dei servizi Cloudflare), si tratta di cambiare le credenziali di accesso (password o altro), specie quelle memorizzate per comodità su vari dispositivi (smartphone, PC, ecc). Discorso analogo, anche se tecnicamente più complesso, per le credenziali di autenticazione fra server che collaborano alla fornitura di servizi online.

Per quanto riguarda eventuali altri dati che possono essere stati esposti a chi non era autorizzato a leggerli, considerato il breve lasso di tempo e la sostanziale "oscurità" del malfunzionamento, si ritiene che non ci sia stato il tempo materiale per approfittarne (exploit).

Conclusioni


Come sempre ripetiamo, non esiste sicurezza assoluta e, al crescere della complessità delle architetture IT, il rischio cresce in maniera non lineare.

L'importante è disporre (come in questo caso) di un'organizzazione pronta ed efficiente, in grado di ridurre al minimo il danno in caso di incident.

Come dire: qualche bue è scappato, ma la porta della stalla stavolta è stata chiusa prima che fuggissero tutti i buoi.